
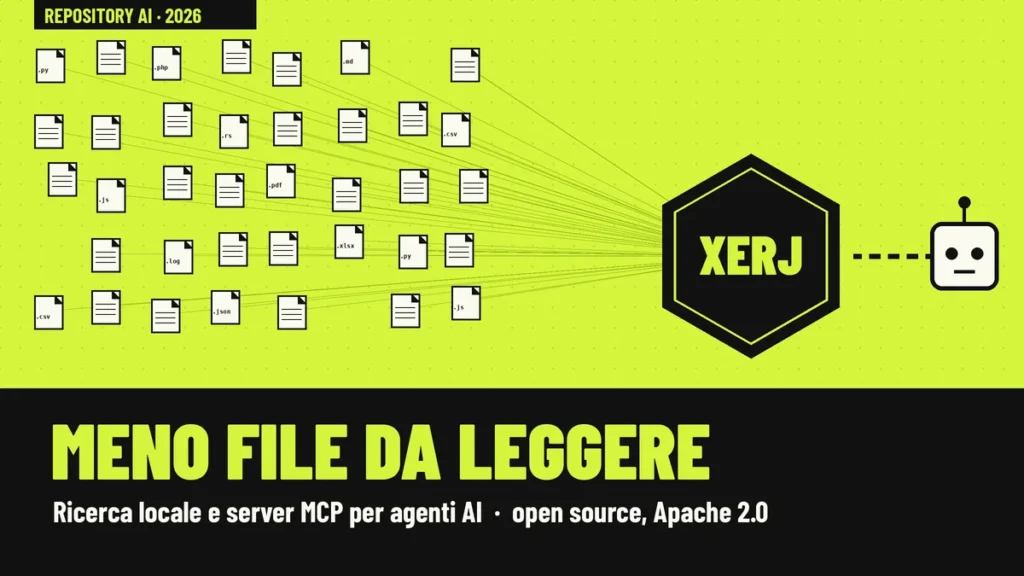
XERJ è un motore di ricerca open source che gira sul tuo computer e fa da memoria per gli agenti AI di programmazione. Un solo eseguibile scritto in Rust indicizza cartelle di codice, documenti, log e PDF. Poi risponde alle domande dell’agente con il passaggio giusto, senza fargli leggere i file uno per uno. Il repository su GitHub è nato il 30 giugno 2026 e al 24 ottobre ha superato le 14.000 stelle. Se vuoi provarlo, parti dalla versione 1.0.0-rc.98 del 21 ottobre: corregge una vulnerabilità del pannello di gestione resa pubblica il 20 ottobre.
Il progetto è distribuito con licenza Apache 2.0, quindi puoi usarlo anche in azienda senza costi di licenza. È ancora una release candidate: la versione 1.0 stabile non è uscita. Qui sotto trovi come funziona, cosa promette, quali numeri sono verificabili e cosa controllare prima di installarlo.
Il problema che XERJ vuole risolvere
Un agente come Claude Code, Cursor o Codex lavora dentro una finestra di contesto limitata. Quando cerca qualcosa nel progetto di solito usa grep: trova una riga, poi apre l’intero file per capire se è quella giusta. Ogni file aperto consuma token, e i token si pagano. Nelle misure pubblicate nel README del progetto, un agente basato su grep è arrivato a caricare fino a 1,06 milioni di token in ingresso su una sola raccolta di codice.
XERJ sposta il lavoro su un indice. L’agente non legge più i file. Fa una domanda al motore di ricerca e riceve il frammento pertinente, con il nome del file e il numero di riga. Una ricerca costa pochi kilobyte di testo invece di interi file.
Come funziona
Avvii il server, poi lanci il comando autoindex su una cartella. XERJ analizza ogni file, riconosce di che tipo è e crea un indice per ogni gruppo di dati che trova, senza schemi da scrivere. Il codice sorgente passa da tree-sitter, una libreria che legge la struttura del linguaggio: così l’indice conosce funzioni, classi e numeri di riga oltre al testo. Quando modifichi pochi file e rilanci l’indicizzazione, XERJ rielabora solo quelli cambiati.
I formati gestiti sono molti. La lista ufficiale comprende:
- codice sorgente, con simboli e numeri di riga;
- CSV, JSON, JSONL, XML, YAML e database SQLite;
- PDF, documenti Word (DOCX), presentazioni PowerPoint e fogli Excel;
- pagine HTML, libri EPUB, notebook Jupyter e pagine di manuale;
- email in formato EML e caselle mbox, oltre ai formati di log più comuni.
Gli eseguibili sono già pronti per Linux, macOS e Windows, su processori x86-64 e ARM64. Non serve Java né altre dipendenze. Esiste anche una procedura per installarlo su macchine senza internet.
Tre modi di cercare nello stesso motore
XERJ offre la ricerca testuale classica con l’algoritmo BM25, la ricerca vettoriale per somiglianza e la ricerca ibrida che fonde le due. C’è un dettaglio che conviene conoscere. Il calcolo dei vettori predefinito è lessicale: misura le parole in comune, non il significato. La modalità neurale, che coglie il senso delle frasi, va attivata a parte e scarica circa 90 MB di modelli.
Per gli agenti esiste anche una memoria persistente. L’agente può salvare ciò che ha imparato in uno spazio dedicato e richiamarlo nella sessione successiva, cercando per testo o per significato.
Il collegamento con gli agenti tramite MCP
Lo stesso eseguibile fa anche da server MCP (Model Context Protocol), lo standard con cui gli assistenti AI si collegano a strumenti esterni. Il comando xerj mcp espone 21 strumenti: ricerca testuale, semantica, vettoriale e ibrida, ricerca delle definizioni nel codice, memoria dell’agente e altri. Il comando xerj init registra XERJ in Claude Code e Cursor in un solo passaggio.
Il README elenca 26 programmi compatibili, da OpenCode a Zed, da Goose a GitHub Copilot in VS Code. Va letto con attenzione: solo due sono stati provati davvero, OpenCode e Cline. Per gli altri la configurazione è ricavata dalla documentazione dei rispettivi produttori e nessuno l’ha ancora verificata.
Compatibile con le API di Elasticsearch
XERJ risponde con le stesse API REST di Elasticsearch, sulla porta 9200. Le librerie client ufficiali e Kibana si collegano senza modifiche. La suite di test di compatibilità passa 1.366 casi su 1.369, e i tre mancanti sono elencati nel repository. Il progetto precisa di essere compatibile con le API, non una copia interna di Elasticsearch né un suo fork.
Nei benchmark pubblicati dagli sviluppatori contro Elasticsearch 8.13.4, XERJ ottiene 55 vittorie, 26 pareggi e 4 sconfitte. Dichiara un’indicizzazione 1,72 volte più veloce e uno spazio su disco 1,61 volte più piccolo. Le quattro sconfitte riguardano tutte lo stesso punto: le letture mentre è in corso una scrittura molto intensa. Sono numeri del produttore, con il metodo pubblicato per ripeterli.
Quanto fa risparmiare: i numeri e i loro limiti
Il dato che ha fatto girare il progetto viene da uno studio degli stessi autori. Hanno dato a Claude Code 8 compiti in Python, JavaScript, C e Java, ripetuti 16 volte per ogni modalità. Le librerie usate erano sconosciute al modello. Ecco il risultato:
| Modalità | Token in uscita | Costo | Compiti risolti |
|---|---|---|---|
| Solo memoria del modello | 260.916 | 11,18 $ | 11 su 16 |
| Agente con grep | 26.477 | 3,27 $ | 16 su 16 |
| Agente con XERJ | 9.982 | 1,58 $ | 16 su 16 |
Rispetto alla ricerca con grep, i token in uscita scendono di 2,7 volte a parità di compiti risolti. I token in uscita sono quelli che costano di più, quindi il risparmio pesa sulla bolletta delle API.
Gli autori dichiarano anche i limiti, e sono importanti. Le librerie del test sono state scritte apposta, proprio perché il modello non le conoscesse. Su codice pubblico molto diffuso, che il modello ha già visto durante l’addestramento, la ricerca non aiuta e anzi aggiunge lavoro. In quel controllo l’agente senza strumenti è risultato il più economico. Un codice aziendale privato e grande non è ancora stato misurato.
Sicurezza: cosa controllare prima di installarlo
La parte più delicata è la configurazione di avvio. Tutte le guide rapide usano l’opzione –insecure, che spegne sia la crittografia TLS sia l’autenticazione. Con questa opzione chiunque raggiunga la porta del server ha pieni poteri: può leggere e cancellare ogni indice, memorie degli agenti comprese. Il modello di sicurezza la riserva a un solo utente su un computer di sviluppo.
Ci sono però alcune protezioni attive di serie. Un nuovo server ascolta solo su 127.0.0.1, cioè sulla macchina locale. Se provi a esporlo in rete senza TLS, si rifiuta di partire finché non lo autorizzi in modo esplicito. Senza –insecure l’autenticazione è attiva e al primo avvio viene generata una chiave di amministrazione.
Restano alcuni limiti dichiarati dagli stessi sviluppatori:
- TLS è spento di default e la porta gRPC 8081 non è mai cifrata;
- i dati salvati su disco non sono cifrati dal motore, serve la cifratura del disco;
- non esiste un controllo degli accessi completo per ruoli, né restrizioni a livello di campo o di documento;
- il riordino dei risultati con il servizio esterno Jev invia il testo dei documenti ai server di TypeSafe AI, ma resta spento finché non inserisci una chiave.
Poi c’è la falla CVE-2026-97406, pubblicata dal CERT il 20 ottobre. Chi possedeva un token API valido poteva creare altri token indipendenti dal pannello di gestione. Revocare il token originale non bastava, perché i nuovi continuavano a funzionare. Con un token del proprietario si poteva perfino registrare una propria passkey e prendere il controllo dell’istanza. La versione 1.0.0-rc.98 chiude il problema: creare o revocare token, emettere inviti e cancellare passkey ora richiede una sessione del browser autenticata con passkey.
Cosa cambia per chi sviluppa software e automazioni
Gli agenti di programmazione costano soprattutto per i token, e una parte di quei token serve solo a cercare. Un indice locale riduce questa spesa e tiene il codice sulla tua macchina, perché l’indicizzazione e la ricerca non escono dal computer. Gestionali e progetti su misura sono codice privato, assente dai dati di addestramento dei modelli. È la situazione più vicina a quella in cui lo studio ha misurato il vantaggio.
XERJ può anche sostituire un database vettoriale separato nei progetti RAG, perché ricerca testuale e vettoriale stanno nello stesso motore. Chi usa già Elasticsearch per i log può valutarlo come alternativa più leggera. In entrambi i casi conviene ricordare che il progetto è giovane, cambia ogni giorno e non ha ancora una versione stabile.
Il nostro consiglio
XERJ merita una prova, ma su una macchina di sviluppo e con qualche regola chiara. Questi sono i passi che seguiremmo:
- installa la versione 1.0.0-rc.98 o successiva e aggiornala spesso;
- se il server non resta sul tuo solo computer, avvialo senza –insecure, con TLS attivo o dietro un proxy che lo gestisce;
- tieni la cartella dei dati fuori dalle cartelle che indicizzi, altrimenti XERJ indicizza il proprio archivio;
- non attivare il riordino esterno sui progetti riservati;
- prima di copiare codice da repository di terzi indicizzati, controlla la licenza: per i progetti GPL e AGPL gli autori consigliano di leggere solo l’approccio;
- misura il risparmio sul tuo codice con il comando xerj gain, invece di fidarti dei numeri dello studio.
Vuoi capire se un motore di ricerca locale può ridurre i costi dei tuoi agenti AI o dei tuoi progetti RAG? Scrivici e valutiamo insieme la configurazione più sicura.
Fonti
- GitHub – xerj-org/xerj (repository, licenza Apache 2.0)
- XERJ – README del progetto
- XERJ – Case study: reference coding
- XERJ – Benchmark contro Elasticsearch
- XERJ – Security model
- XERJ – Changelog
- GitHub – Release v1.0.0-rc.98
- CERT/CC – Vulnerability Note VU#645818 (CVE-2026-97406)
- Model Context Protocol – documentazione ufficiale

